Airflow AI Provider 1.0: novedades y primer DAG con IA
Equipo Nubita · Publicado el · 10 min de lectura
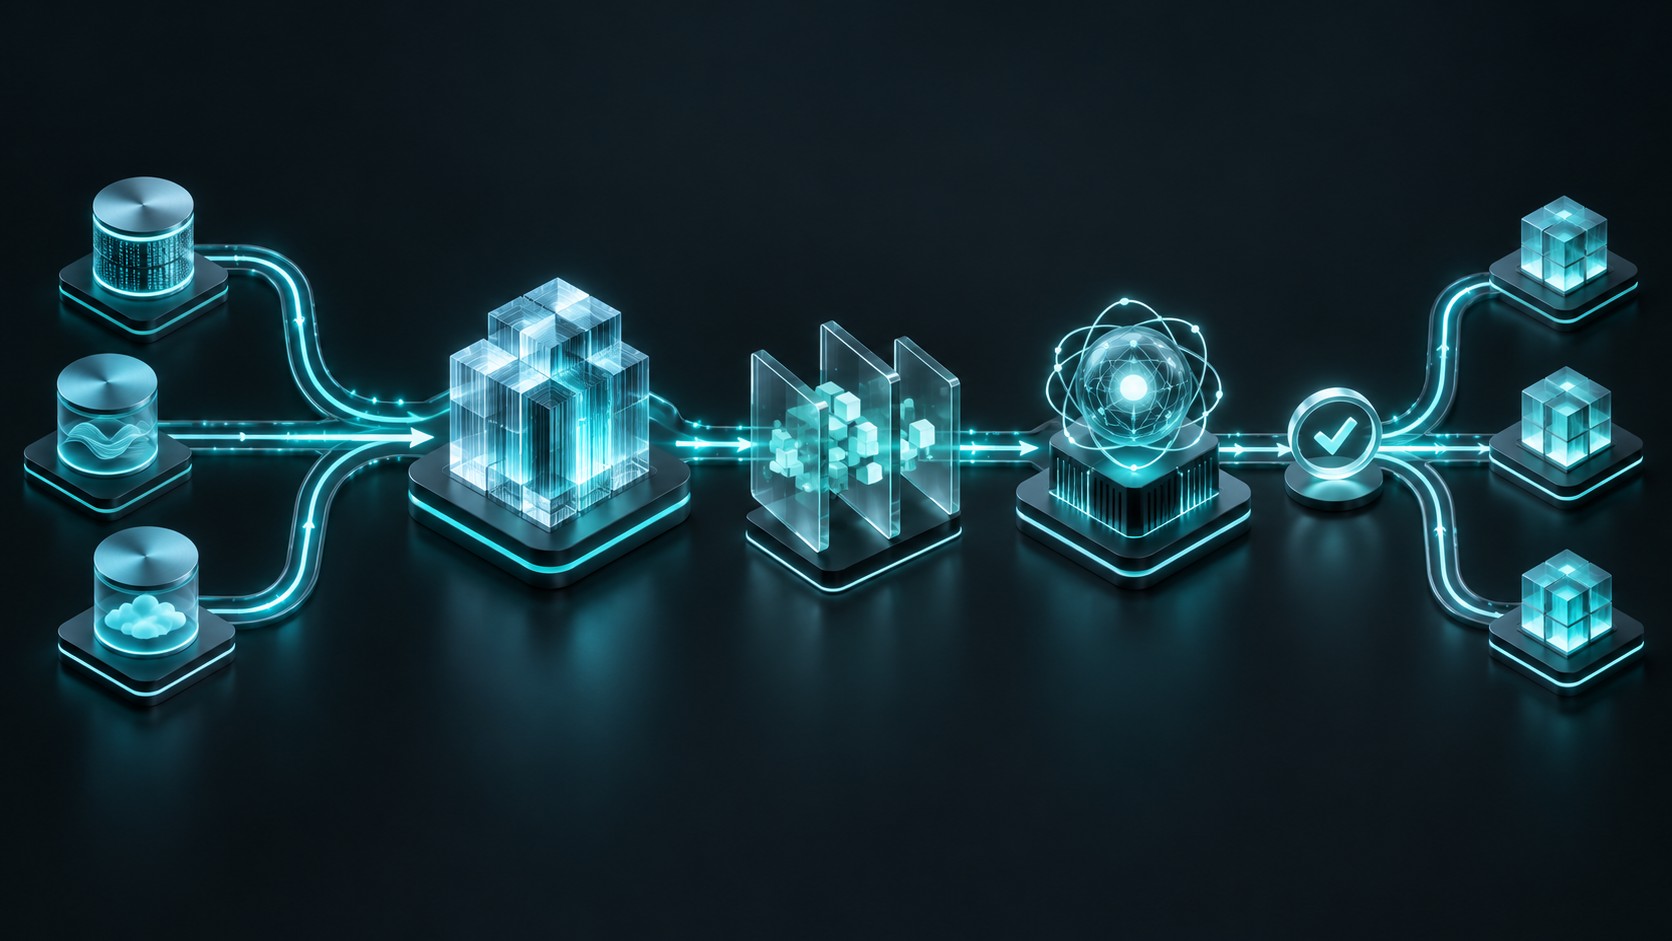
Un pipeline termina de cargar datos, dbt ejecuta sus comprobaciones y el equipo recibe un informe con las incidencias. La IA puede ayudar a interpretar ese resultado y preparar una explicación para quien debe actuar. Para que sea útil, necesita datos verificables, una tarea concreta y permisos bien definidos.
El 19 de octubre de 2026, Apache Airflow publicó el anuncio de Common AI Provider 1.0, el paquete apache-airflow-providers-common-ai. Esta guía del 26 de octubre repasa la novedad y propone un primer ejercicio con datos ficticios. El lanzamiento es del provider: no significa que Airflow Core haya pasado a la versión 1.0. Leer el anuncio oficial.
Qué aporta la versión 1.0
El provider integra tareas con modelos de lenguaje y agentes en los DAGs de Airflow. Las novedades descritas en el anuncio incluyen herramientas para almacenamiento de objetos, sandboxes y políticas de reintento asistidas por modelos, además de ampliaciones en la integración con distintos frameworks.
Conviene distinguir dos formas de empezar: @task.llm envía una petición al modelo y devuelve su respuesta; @task.agent permite que el modelo solicite llamadas a las herramientas que hayas configurado. Para resumir un informe ya calculado, una tarea LLM puede ser suficiente. Guía de operadores y decoradores.
Requisitos: la versión de Airflow también importa
El provider requiere Python 3.11 o posterior y Airflow 2.11 o posterior. Eso no garantiza que todas sus funciones estén disponibles en cualquier combinación. Este ejemplo utiliza las importaciones de Airflow 3 y toma Airflow 3.3.2 como referencia.
- Pausa para aprobar una llamada a una herramienta: necesita Airflow 3.3. En versiones anteriores, llamar a una herramienta marcada para aprobación hace fallar la tarea.
- Políticas de reintento: requieren Airflow 3.3.
- Airflow 2.11: utiliza importaciones diferentes; no copies sin adaptar el código de esta guía.
Comprueba la matriz de compatibilidad y las dependencias de tu instalación antes de actualizar. Instalación y requisitos por función.
Dónde encaja con S3, Snowflake y dbt
En un stack como el de Nubita, podemos plantear este recorrido:
- Amazon S3: recibe los archivos de origen.
- Snowflake: carga los registros y permite comprobar las cifras.
- dbt: transforma los datos y ejecuta las validaciones acordadas.
- Airflow: coordina las dependencias y añade una tarea de IA para explicar un resumen de resultados.
Es una arquitectura propuesta, no una integración automática que aparezca al instalar el provider. Las cargas, los modelos dbt y los controles siguen necesitando sus tareas y conexiones. Para un primer piloto, enviaría al modelo unos pocos indicadores agregados, sin credenciales ni registros personales.
Por ejemplo, ante una caída de pedidos, el resumen podría señalar que faltan archivos o que falló una comprobación. Con esos indicios todavía no se puede atribuir una causa comercial. La explicación debe separar los hechos calculados de las hipótesis.
1. Prepara una instalación de pruebas
Parte de una instalación funcional de Airflow en un entorno de pruebas. Si utilizas Airflow 3.3.2, este comando mantiene esa versión explícita e instala el extra del proveedor de modelos elegido para el ejemplo:
python -m pip install "apache-airflow==3.3.2" "apache-airflow-providers-common-ai[openai]==1.0.0"No ejecutes una actualización directamente sobre tu entorno de producción. Revisa la resolución de dependencias y conserva la imagen o el entorno que valides. Instala el provider en los componentes que lo necesiten, incluidos los workers que ejecutarán las tareas.
2. Configura la conexión al modelo
En la administración de conexiones de Airflow, crea una conexión de tipo Pydantic AI con identificador pydanticai_default. Configura la clave en el campo Password y el modelo en formato proveedor:modelo; por ejemplo, openai:gpt-5 si tienes acceso a ese modelo.
Elige un modelo disponible en tu cuenta y un extra compatible con él. Las credenciales deben gestionarse mediante Connections o el backend de secretos de tu instalación, fuera del DAG y del repositorio. Configuración oficial de la conexión.
3. Añade un primer DAG con datos ficticios
Guarda este archivo como nubita_ai_informe.py en la carpeta de DAGs. La primera tarea genera un resumen ficticio; no lee S3, no consulta Snowflake y no ejecuta dbt. Así podemos evaluar la tarea de IA antes de conectarla a un pipeline real.
import json
from airflow.sdk import dag, task


@dag(schedule=None, catchup=False, tags=["nubita", "ai", "demo"])
def nubita_ai_informe():
    @task
    def metricas_demo() -> dict:
        return {
            "tipo": "datos ficticios",
            "archivos_s3_esperados": 3,
            "archivos_s3_recibidos": 3,
            "pedidos_periodo_anterior": 100,
            "pedidos_periodo_actual": 90,
            "variacion_pedidos_pct": -10,
            "tests_dbt_fallidos": 0,
        }

    @task.llm(
        llm_conn_id="pydanticai_default",
        system_prompt=(
            "Redacta en espanol un informe breve a partir del JSON. "
            "Respeta sus cifras. Separa hechos de hipotesis. "
            "No atribuyas causas que los datos no demuestren."
        ),
    )
    def redactar_informe(metricas: dict) -> str:
        return "Explica este resultado ficticio: " + json.dumps(metricas)

    @task
    def mostrar_borrador(informe: str):
        print(informe)

    mostrar_borrador(redactar_informe(metricas_demo()))


nubita_ai_informe()
Ejecuta airflow dags test nubita_ai_informe desde el entorno preparado o lanza el DAG desde la interfaz. La tarea LLM realiza una llamada real al proveedor del modelo y puede generar consumo. Su respuesta pasa a la tarea siguiente mediante XCom; aquí únicamente se imprime un borrador con información ficticia. Quickstart oficial.
4. Comprueba el resultado antes de usar datos reales
El informe debería indicar que llegaron tres archivos de tres esperados, que los pedidos bajaron un 10 % y que no hay tests dbt fallidos. Con esas cifras no se sabe por qué bajaron los pedidos. Si el modelo afirma que fue por falta de stock, precios o una campaña, está añadiendo una explicación sin evidencia.
Prueba también un caso con un archivo ausente y otro con un test fallido. Acuerda qué hechos debe mencionar y qué afirmaciones debe evitar. Cuando sustituyas la tarea ficticia, calcula los indicadores con SQL o código y utiliza resultados pequeños y agregados. No envíes tablas completas por XCom para que el modelo haga las cuentas.
Si necesitas un agente con herramientas
El siguiente paso puede ser un agente con acceso a una selección de herramientas. SQLToolset rechaza escrituras por defecto y permite configurar tablas autorizadas. Esos controles de aplicación no sustituyen a un rol de Snowflake con permisos mínimos: la conexión debe limitar de verdad lo que se puede leer o ejecutar.
Las instrucciones y las respuestas del modelo también requieren cuidado. Evita introducir datos sensibles en prompts y trata su salida como contenido que necesita validación antes de utilizarlo en otro sistema. Controles de seguridad de las herramientas.
Aprobación humana, reintentos y sandboxes: límites importantes
Aprobación de herramientas: en Airflow 3.3, el mecanismo permite pausar una tarea antes de una llamada marcada para aprobación, con un límite de una solicitud por instancia de tarea y ejecución del DAG, incluidos reintentos y limpiezas. No se puede combinar con ciertas opciones, como durable=True o un sandbox iniciado por SandboxToolset. Detalles y restricciones de aprobación.
Reintentos: LLMRetryPolicy y ClassifierRetryPolicy permiten delegar o clasificar decisiones de reintento. Para errores conocidos, empieza por reglas deterministas; si incorporas un modelo, evalúa sus decisiones y configura una alternativa. Repetir una tarea con efectos externos exige que esos efectos sean idempotentes: un reintento no debería crear dos veces el mismo resultado. Guía de políticas de reintento.
Sandboxes: su implementación y sus backends son experimentales. Aíslan el código que genera el modelo; el bucle del agente y otras herramientas pueden seguir ejecutándose en el worker. No asumas que toda la tarea queda aislada por añadir un sandbox. Backends y estado de los sandboxes.
Cómo elegir un primer caso de uso
Un resumen de incidencias de carga o de resultados de calidad es un punto de partida acotado: tiene hechos contrastables y un destinatario claro. Mide exactitud, tiempo de revisión, coste por ejecución y utilidad del borrador. Mantén el control de errores, las validaciones y la decisión de publicar el resultado en el flujo que hayas definido.
Si quieres comparar este enfoque con un agente que se consulta desde una aplicación, puedes leer nuestra guía de Snowflake Cortex Agent SDK con Python. Para preparar fuentes, métricas y orquestación, consulta Nubita Data Platform o nuestra consultoría de datos.
Nota de la guía: documentación consultada el 26 de octubre de 2026. El código se ha contrastado con los ejemplos oficiales y revisado sintácticamente; no se ha ejecutado en una instalación de Airflow ni contra un proveedor de modelos. Valida dependencias, permisos y comportamiento en tu entorno antes de utilizarlo en producción.
Lleva estas ideas a tu empresa
Define indicadores con nuestra consultoría de Business Intelligence y Power BI, integra tus fuentes con Nubita Data Platform o empieza por una estrategia de datos adaptada a tu negocio.